
Las 10 mejores API de scraping de Amazon para acceder a datos fiables
Una API de scraping de Amazon puede convertir páginas de productos, resultados de búsqueda, ofertas, reseñas y perfiles de vendedores en datos procesables por una aplicación. Lo difícil es mantenerlos completos mientras Amazon cambia diseños, varía resultados por ubicación y desafía las solicitudes automatizadas. Un precio bajo por solicitud aporta poco valor si el flujo recibe repetidamente páginas bloqueadas, campos incompletos o resultados del marketplace equivocado.
Esta guía compara 10 opciones de API de scraping de Amazon para flujos habituales de datos de productos. La comparación es práctica: qué devuelve cada servicio, dónde encaja y qué debe seguir manteniendo el equipo. También explica por qué un scraper administrado no elimina todos los problemas de calidad. El objetivo es separar las funciones de extracción de páginas de los datos comerciales que realmente necesita un flujo de comercio electrónico. Los equipos que necesitan datos de productos, palabras clave, competidores, reseñas, historial de precios, ventas y mercados pueden obtener un resultado más limpio con una Amazon Data API estructurada en lugar de crear varios scrapers específicos de páginas.
Comparación de API de scraping de Amazon
La siguiente tabla ofrece una vista rápida de las 10 opciones. Los precios cambian con frecuencia, por lo que la columna describe el modelo de facturación en lugar de citar una tarifa promocional temporal.
| Herramienta | Salida habitual | Cobertura principal de Amazon | Modelo de precios | Uso más adecuado |
|---|---|---|---|---|
| Bright Data | JSON, CSV | Productos, reseñas, vendedores, precios y más vendidos | Por registro correcto y planes por volumen | Recopilación a escala empresarial |
| Oxylabs | JSON, HTML | Productos, búsquedas, precios, vendedores y más vendidos | Suscripción y niveles de uso | Analizadores específicos de Amazon |
| Decodo | JSON, HTML | Productos, búsquedas, precios, vendedores y más vendidos | Uso basado en créditos | Scraping configurable a escala |
| Zyte | JSON, HTML | Extracción flexible de URL y esquemas de productos | Precios dinámicos por solicitud | Rastreadores y extracción personalizados |
| ZenRows | JSON estructurado, HTML | Productos, reseñas, búsquedas y solicitudes localizadas | Planes basados en créditos | Endpoints de Amazon accesibles para desarrolladores |
| ScrapingBee | JSON, HTML | Búsquedas, productos, precios y reseñas | Planes basados en créditos | Integración API sencilla |
| Apify | JSON, CSV y conjuntos de datos | Depende del Amazon Actor seleccionado | Cómputo o pago por resultado | Flujos personalizados programados |
| Rainforest API | JSON, CSV | Productos, ofertas, búsquedas, vendedores, reseñas y categorías | Planes por solicitudes | Datos de productos específicos de Amazon |
| SerpApi | JSON, HTML | Resultados de búsquedas y productos de Amazon | Búsquedas mensuales | Posiciones de búsqueda y datos SERP |
| ScraperAPI | JSON, HTML | Búsquedas, productos, ofertas, precios y reseñas | Planes basados en créditos | Infraestructura general de scraping |
Los criterios de selección son deliberadamente sencillos. Las comparaciones útiles incluyen cobertura específica de Amazon, salida estructurada, localización por marketplace, gestión de solicitudes fallidas y trabajo que queda al cliente. El precio por solicitud anunciado más bajo no siempre supone el menor coste por registro utilizable. Los multiplicadores de JavaScript, proxies prémium, reintentos, actualizaciones de analizadores y validación de datos pueden cambiar considerablemente el coste final.
Las 10 mejores API de scraping de Amazon
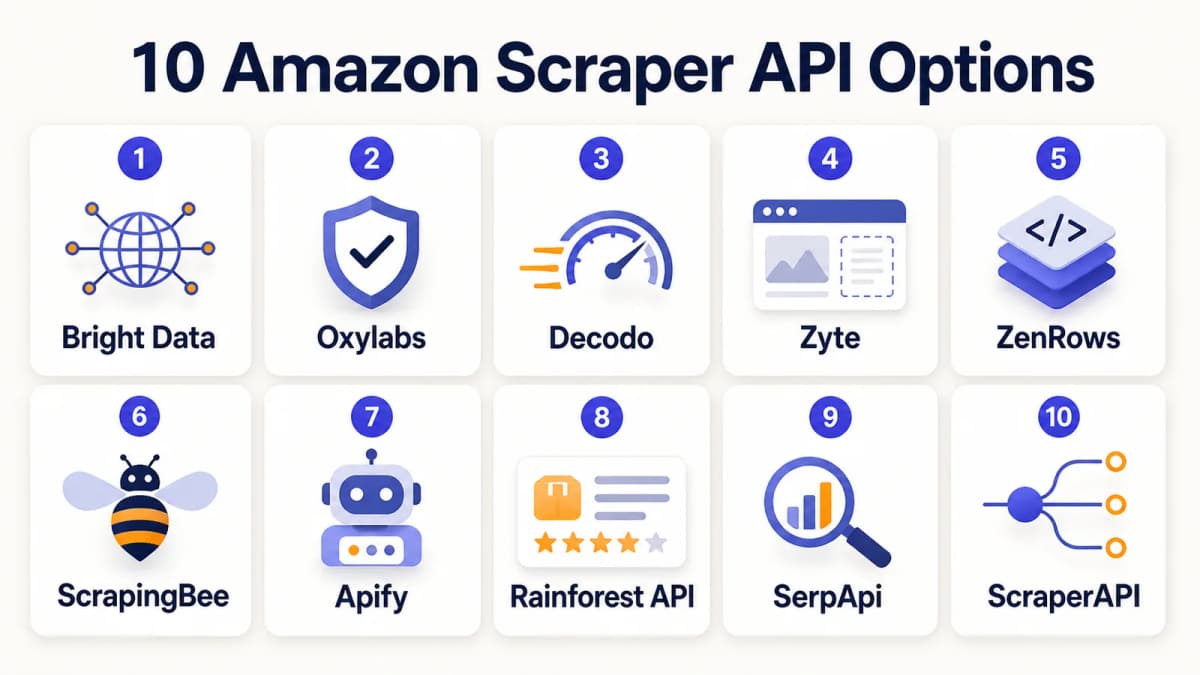
No existe un ganador universal para todos los proyectos de scraping de Amazon. Un sistema de seguimiento de precios, un proceso de análisis de reseñas y un monitor de posiciones necesitan campos y patrones de actualización diferentes. Las opciones siguientes se organizan por su uso más sólido, no por una clasificación general de rendimiento sin respaldo.
1. Bright Data para trabajar a escala
Bright Data ofrece scrapers específicos de Amazon para productos, reseñas, ASIN, vendedores, precios y páginas de más vendidos. Los resultados pueden entregarse como JSON estructurado o CSV, y el servicio gestiona detrás de la API el renderizado del navegador, los proxies y los desafíos CAPTCHA.
Su principal ventaja es la amplitud. Un equipo puede combinar recopilación en tiempo real, tareas programadas y conjuntos de datos grandes bajo un proveedor. Esa amplitud también introduce más configuración y una contratación empresarial de mayor coste de lo que quizá necesite un proyecto pequeño. Bright Data encaja con equipos que valoran escala de infraestructura, opciones de entrega y un amplio catálogo de recopiladores preparados.
2. Oxylabs para analizadores específicos
Oxylabs proporciona fuentes específicas de Amazon para páginas de productos, resultados, ofertas de precios, vendedores y más vendidos. Incluyen analizadores que devuelven campos estructurados, mientras que una fuente general de URL de Amazon admite solicitudes adicionales con un análisis más limitado.
Esta configuración funciona bien para equipos que quieren infraestructura consolidada y control sobre parámetros y salida. La limitación práctica es el alcance: recopilar métricas comerciales adicionales puede seguir requiriendo solicitudes, almacenamiento, normalización y análisis independientes fuera del scraper.
3. Decodo para la configuración
Decodo combina una Web Scraping API general con plantillas de Amazon para más vendidos, precios, productos, búsquedas y vendedores. Las plantillas compatibles pueden devolver JSON analizado y los objetivos de Amazon utilizan infraestructura de proxies prémium de forma predeterminada.
El servicio es útil cuando un desarrollador quiere configurar el nivel de renderizado, localización y extracción necesario por solicitud. Sin embargo, el consumo de créditos puede variar con la complejidad. Los equipos deben probar el objetivo exacto de Amazon, marketplace y nivel de concurrencia antes de estimar el coste de producción.
4. Zyte para rastreadores personalizados
Zyte API es un servicio general de extracción web, no un producto exclusivo de Amazon. Combina gestión automática de bloqueos, rotación de IP, renderizado del navegador, sesiones y extracción estructurada mediante una API. También se integra estrechamente con flujos de rastreo basados en Scrapy.
Zyte encaja bien cuando el proyecto necesita más que un conjunto fijo de endpoints de Amazon o ya tiene lógica de rastreo propia. Esa flexibilidad implica que el cliente debe definir el rastreo, elegir la salida, validar campos importantes y supervisar cambios en las páginas objetivo.
5. ZenRows para simplificar el desarrollo
ZenRows ofrece endpoints de scraping de comercio electrónico específicos para productos, reseñas y búsquedas de Amazon. Las llamadas pueden localizarse por dominio y país, y el servicio devuelve datos estructurados sin que el cliente mantenga un analizador de páginas para los endpoints compatibles.
Está indicado para desarrolladores que buscan una integración HTTP sencilla y no quieren configurar un grupo de proxies. Los equipos deben confirmar que se admitan todos los campos y tipos de página necesarios. Un endpoint de producto quizá no sustituya la inteligencia específica de palabras clave, estimaciones de ventas, estadísticas de mercado o datos históricos de largo plazo.
6. ScrapingBee para equipos pequeños
ScrapingBee ofrece endpoints específicos de Amazon junto a su API general. Una solicitud de búsqueda puede devolver resultados estructurados mientras el servicio gestiona proxies, renderizado JavaScript y desafíos de bloqueo habituales.
Su formato sencillo resulta accesible para equipos pequeños y prototipos. Los multiplicadores de créditos y la configuración avanzada de renderizado siguen afectando al coste efectivo. Los datos también se centran en lo que aparece en páginas compatibles de Amazon, por lo que métricas de investigación más profundas requieren procesamiento adicional u otra fuente.
7. Apify para flujos personalizados
Apify aloja numerosos Amazon Actors que recopilan productos, búsquedas, reseñas, ofertas, vendedores, más vendidos y otros tipos de páginas. Las ejecuciones pueden programarse, utilizarse mediante API y exportarse a conjuntos de datos en formatos como JSON y CSV.
El detalle importante es que Apify es una plataforma, no un scraper de Amazon uniforme. Cada Actor tiene distintos desarrolladores, calendarios de mantenimiento, cobertura de marketplaces, precios y esquemas de salida. Apify funciona bien cuando un equipo quiere flexibilidad y está dispuesto a evaluar y supervisar el Actor elegido.
8. Rainforest API para datos de Amazon
Rainforest API se centra en Amazon y obtiene datos en tiempo real de dominios de Amazon de todo el mundo. Sus tipos de solicitud documentados cubren productos, ofertas, ofertas relámpago, categorías, búsquedas, perfiles de vendedores, valoraciones de vendedores, productos de vendedores, preguntas y más vendidos.
El modelo de solicitudes específico de Amazon resulta más fácil de utilizar que HTML sin procesar. Sirve para aplicaciones centradas en datos de catálogo y ofertas en directo. Los equipos que necesitan historial de palabras clave, cuota de tráfico, puntuaciones de oportunidad, estimaciones de ventas de varias fuentes o inteligencia de mercado más amplia pueden seguir necesitando otras integraciones.
9. SerpApi para resultados de búsqueda
SerpApi proporciona Amazon Search y Amazon Product APIs. La API de búsqueda devuelve campos estructurados de resultados orgánicos, productos destacados, anuncios de productos, búsquedas relacionadas y ubicaciones patrocinadas. Admite dominios, idiomas, códigos postales de entrega, ubicaciones de envío y filtros de Amazon.
SerpApi encaja naturalmente con el seguimiento de búsquedas y el análisis de posiciones de Amazon. Es menos adecuado como única fuente de investigación amplia porque su fortaleza es la superficie de resultados, no un conjunto completo de palabras clave, reseñas, ventas, historial de precios y oportunidades de mercado.
10. ScraperAPI para acceso general
ScraperAPI combina infraestructura general de scraping con endpoints estructurados de Amazon. Su cobertura incluye búsquedas, ASIN de productos, ofertas, precios y reseñas, con JSON disponible para solicitudes estructuradas compatibles.
Esta opción encaja con equipos que ya utilizan un proveedor general y quieren añadir páginas de Amazon sin operar proxies directamente. Como con otros servicios, el cliente debe comprobar campos completos, normalizar salidas, guardar instantáneas históricas y detectar resultados técnicamente correctos pero inadecuados para el análisis previsto.
Riesgos de fiabilidad del scraping de Amazon
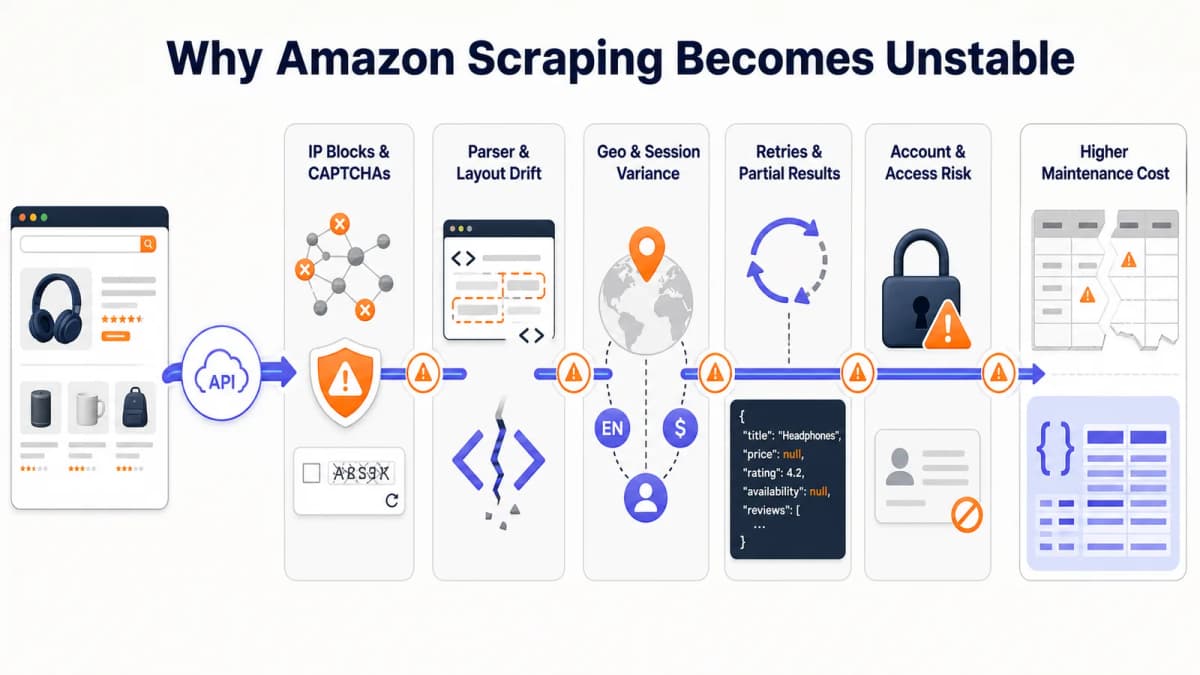
Las API de scraping administradas eliminan mucho trabajo de infraestructura, pero no convierten las páginas de Amazon en estáticas ni uniformes. Los siguientes riesgos importan cuando un flujo depende de datos recientes y repetibles.
Bloqueos de IP y CAPTCHA
Amazon puede desafiar las solicitudes automatizadas según la reputación de IP, frecuencia, señales TLS y de navegador, comportamiento de sesión y otros patrones de acceso. Los proveedores responden con rotación de proxies, renderizado del navegador, gestión de sesiones y reintentos.
Estos sistemas reducen la carga de infraestructura del cliente, pero el resultado puede seguir siendo una solicitud fallida, una página CAPTCHA o una respuesta más lenta que consume más créditos. La tasa de éxito anunciada debe probarse con el tipo exacto de página y marketplace que necesita la aplicación.
Cambios de analizadores y diseño
Amazon cambia el marcado, el orden de componentes, etiquetas y datos incrustados. Un analizador que funcionaba ayer puede devolver un precio vacío, el vendedor equivocado, una variante ausente o reseñas incompletas tras un cambio de diseño.
Los endpoints específicos reducen ese riesgo porque el proveedor mantiene el analizador. No eliminan la necesidad de validar la salida. Una respuesta HTTP válida no demuestra que todos los campos comerciales obligatorios estén presentes o sean correctos. Los sistemas de producción siguen necesitando comprobar esquemas, tratar nulos y alertar sobre cambios bruscos de campos.
Variaciones por ubicación y sesión
Los resultados de Amazon pueden variar por marketplace, código postal, idioma, divisa, dirección de entrega, dispositivo, estado de cookies e inicio de sesión. El mismo ASIN puede mostrar distintas ofertas, fechas de entrega, disponibilidad o precios en sesiones diferentes.
Por tanto, la compatibilidad con ubicaciones debe evaluarse como un requisito de datos, no una función secundaria del proxy. Un flujo fiable registra el marketplace y parámetros de localización solicitados con cada resultado. También evita comparar valores recopilados con distintas configuraciones como si representaran el mismo mercado.
Reintentos y resultados parciales
Los reintentos elevan el coste efectivo del scraping. Algunos servicios cobran solo por registros correctos, mientras otros consumen créditos según renderizado, tipo de proxy, dificultad de página o intentos. El modelo debe probarse con cargas realistas y no con un único ASIN sencillo.
Los datos parciales son igual de importantes. Pueden faltar resultados patrocinados, las páginas de reseñas pueden exponer solo un conjunto limitado y las páginas de productos pueden omitir campos en algunas categorías. Deben comprobarse los campos mínimos obligatorios de las respuestas antes de incorporarlas a un modelo de precios, competidores o investigación de productos.
Riesgos de cuenta y acceso
Muchas API de scraping de páginas públicas no requieren iniciar sesión en Amazon. Esto mantiene la cuenta del vendedor fuera de la ruta básica. Los flujos que dependen de sesiones autenticadas, cookies guardadas o credenciales del cliente crean un perfil de riesgo distinto. El acceso automatizado repetido puede activar verificaciones adicionales o restricciones.
Los equipos deben evitar tratar el scraping con cuentas como un atajo para obtener datos ocultos tras la autenticación. La recopilación también debe respetar las condiciones aplicables, requisitos de privacidad, derechos sobre datos y leyes locales. Este artículo no ofrece asesoramiento jurídico ni recomienda eludir controles de acceso.
API de scraping frente a API de datos
Una API de scraping de Amazon resulta adecuada cuando la salida necesaria está vinculada a una página: HTML sin procesar, un componente especial, una captura o un campo propio no disponible en otro lugar. Una Amazon Data API estructurada encaja mejor cuando el objetivo real es un conjunto de datos comerciales repetible.
| Requisito | API de scraping | Amazon Data API estructurada |
|---|---|---|
| Entrada principal | URL, ASIN o consulta de búsqueda | ASIN, palabra clave, marketplace o filtros de investigación |
| Salida habitual | HTML o JSON derivado de páginas | Campos y métricas comerciales definidos |
| Gestión de proxies | La gestiona el proveedor o el cliente | El cliente no mantiene un grupo de proxies |
| Mantenimiento del analizador | Puede corresponder al proveedor o al cliente | El cliente integra contra un esquema de API |
| Análisis histórico | El cliente guarda instantáneas repetidas | Puede estar disponible mediante endpoints de historial |
| Mejor uso | Extracción personalizada de páginas | Análisis de productos, palabras clave, reseñas, ventas y mercados |
Por ejemplo, un desarrollador que necesita un módulo inusual de una página de Amazon puede preferir un scraper flexible. Un equipo que compara ASIN, sigue demanda de palabras clave, analiza reseñas, estima ventas y selecciona nichos necesita varios conjuntos conectados. Crear ese flujo a partir de páginas extraídas requiere almacenamiento, normalización, reintentos, historial y controles de calidad antes de empezar el análisis.
Acceso a datos estructurados de Amazon
Cuando el objetivo pasa de recopilar páginas a tomar decisiones de comercio electrónico, mantener varios procesos de scraping se convierte en una carga innecesaria. Nexscope proporciona una capa independiente de inteligencia de marketplaces de Amazon con acceso estructurado a productos, palabras clave, competidores, reseñas, precios, ventas y mercados.
La Amazon Data API de Nexscope organiza actualmente 34 capacidades documentadas en ocho categorías: investigación de productos; datos e historial de ASIN; inteligencia competitiva; investigación de palabras clave; tráfico, posiciones y cuota de visibilidad; oportunidades de mercado; reseñas y ventas; y compras con IA y políticas.
Datos de productos y ASIN
Los equipos pueden empezar con un producto conocido o crear un conjunto de investigación más amplio:
- Amazon Product Detail devuelve por ASIN título, imágenes, viñetas, especificaciones, contenido A+, precios, valoraciones, variantes y otros campos disponibles.
- Amazon Product Price Series permite analizar datos históricos de precios, BSR, valoraciones, número de vendedores, señales de Buy Box y ventas mensuales.
- Amazon Competitor Lookup encuentra productos competidores por ASIN, palabra clave, vendedor, marca o categoría con métricas de rendimiento.
Estos endpoints respaldan flujos que de otro modo requerirían solicitudes repetidas de páginas, almacenamiento de instantáneas y un proceso separado de emparejamiento de competidores. Los equipos que exploran ideas también pueden combinar los datos con un proceso estructurado de investigación de productos de Amazon.
Datos de palabras clave y mercados
La investigación de Amazon suele comenzar con una palabra clave, no con una URL. Nexscope proporciona capacidades específicas para analizar demanda y mercados:
- Amazon Keyword Intelligence consulta casi tres años de datos de términos de búsqueda de Amazon Brand Analytics en 15 marketplaces.
- Amazon Market Research selecciona nichos por tamaño de mercado, concentración, estructura de vendedores, cuota de productos nuevos y margen.
- Amazon Opportunity Report By Keyword genera un informe de seis dimensiones que abarca mercado, producto, reseñas, compradores, búsqueda y precios.
Esto lleva el flujo más allá de «qué apareció en esta página de búsqueda». Ayuda a examinar demanda, competencia, concentración, señales de compradores y condiciones de lanzamiento mediante campos específicos. Un proceso más amplio de selección de herramientas puede comparar sistemas como Helium 10 y Jungle Scout, pero un flujo API necesita campos documentados que puedan consultarse repetidamente.
Datos de reseñas y ventas
La investigación de reseñas y ventas crea dos problemas frecuentes de scraping: las reseñas públicas disponibles pueden estar incompletas y las métricas de ventas normalmente no existen como un campo sencillo en una página. Nexscope separa esas necesidades en API documentadas:
- Amazon Reviews List obtiene reseñas por ASIN en 15 marketplaces con filtros de estrellas, palabras clave, antigüedad y compradores.
- Amazon Sales Estimates estima ventas diarias en unidades por ASIN y obtiene el último precio conocido durante un periodo seleccionado.
Las estimaciones de ventas son estimaciones y deben tratarse como señales orientativas de investigación, no como totales de unidades comunicados por Amazon. Pueden hacer más coherente la selección de productos cuando se combinan con precio, BSR, valoraciones, reseñas y competidores. Los equipos que comparan flujos de estimación también pueden revisar las herramientas de estimación de ventas de Amazon disponibles.
Acceso REST, MCP y web
La misma capa de datos admite varias formas de trabajar. Los desarrolladores pueden llamar a capacidades compatibles mediante REST API. Los equipos pueden conectar los datos a su propio agente por REST API o MCP conservando el control del agente, modelo, prompts y flujo. Quienes no necesitan una integración externa pueden utilizar las mismas capacidades dentro del producto web de Nexscope.
Nexscope es una plataforma independiente de datos de comercio electrónico centrada en investigación e inteligencia de mercado, no en administración de pedidos, inventario o cuentas. La cobertura, campos, actualización, estimaciones y tratamiento de ausencias varían por capacidad, de modo que la documentación seleccionada sigue siendo la referencia.

Conclusión
La mejor API de scraping de Amazon depende de la salida que realmente necesita el proyecto. Bright Data, Oxylabs, Decodo, Zyte, ZenRows, ScrapingBee, Apify, Rainforest API, SerpApi y ScraperAPI reducen partes de la carga de proxies, renderizado o análisis. Siguen siendo servicios de extracción de páginas, y los equipos deben evaluar campos completos, localización, reintentos, coherencia de salida y coste total de mantenimiento.
Los proyectos que realmente necesitan HTML sin procesar o un elemento personalizado deben elegir un scraper que funcione bien con ese tipo exacto de página. Los equipos que necesitan datos repetibles de productos, palabras clave, reseñas, competidores, historial de precios, ventas y mercados pueden reducir trabajo de ingeniería con endpoints estructurados.
Amazon Data API de Nexscope proporciona esa vía estructurada mediante 34 capacidades documentadas, acceso REST API y MCP para el propio agente del usuario y acceso directo en el producto web. El resultado es menos tiempo manteniendo la extracción de páginas y más tiempo trabajando con datos de comercio electrónico.
Desarrolla con datos estructurados de Amazon
Explora API documentadas de detalles de productos, palabras clave, competidores, reseñas, historial de precios, estimaciones de ventas e inteligencia de mercado.
Explora la documentación de API de Amazon →Preguntas frecuentes
¿Qué es una API de scraping de Amazon?
Una API de scraping de Amazon es un servicio administrado que solicita páginas de Amazon y devuelve su contenido o campos extraídos. Según el proveedor y endpoint, la salida puede ser HTML sin procesar, JSON estructurado, CSV o un conjunto de datos almacenado. Los objetivos comunes incluyen páginas de productos, búsquedas, ofertas, vendedores, listas de más vendidos y reseñas. El proveedor suele gestionar proxies, renderizado del navegador y reintentos, aunque el cliente puede seguir necesitando validar campos, normalizar resultados y guardar instantáneas históricas.
¿Qué datos pueden recopilar las API de scraping de Amazon?
La cobertura varía por proveedor. Los campos habituales incluyen ASIN, título, marca, precio, divisa, disponibilidad, imágenes, valoraciones, número de reseñas, características, variantes, ofertas de vendedores, información de entrega, BSR y posición de búsqueda. Algunos servicios también cubren textos de reseñas, perfiles de vendedores, más vendidos y resultados patrocinados. Un scraper de páginas no proporciona automáticamente todas las métricas comerciales. El historial de palabras clave, estimaciones de ventas, historial de precios de largo plazo, concentración de mercado y puntuaciones de oportunidades pueden requerir fuentes separadas o API específicas.
¿Por qué se bloquean los scrapers de Amazon?
Amazon puede identificar tráfico automatizado mediante reputación de IP, volumen de solicitudes, señales de navegador y TLS, comportamiento de sesión, cabeceras y otros patrones. Una solicitud bloqueada puede devolver un CAPTCHA, página de desafío, error, barrera de inicio de sesión o respuesta incompleta. Las API administradas utilizan proxies rotativos, renderizado, sesiones y lógica de reintentos para mejorar el acceso. El rendimiento sigue variando por tipo de página, marketplace, ubicación y concurrencia, por lo que las pruebas de producción deben usar las mismas condiciones de la carga prevista.
¿Necesitan proxies las API de scraping de Amazon?
La mayoría de las API administradas incluyen infraestructura de proxies, por lo que los clientes no necesitan comprarlos y rotarlos por separado. Algunos servicios seleccionan automáticamente IP de centros de datos o residenciales, mientras otros cobran créditos adicionales por grupos prémium o solicitudes difíciles. Un scraper propio normalmente necesita una estrategia de proxies a escala. Incluso con proxies administrados, los equipos deben supervisar localización, tasas de registros correctos, tiempo de respuesta y campos completos, en lugar de suponer que cada HTTP 200 contiene datos utilizables de Amazon.
¿Puede una API de scraping de Amazon recopilar reseñas?
Algunas API recopilan campos públicos de reseñas como valoración, título, texto, fecha, votos útiles y condición de compra verificada. La disponibilidad real puede variar porque las páginas específicas, paginación, filtros y barreras de inicio de sesión cambian entre marketplaces y sesiones. Un proveedor puede devolver solo las reseñas visibles en la página del producto o un conjunto reciente limitado. Los equipos que dependen de su análisis deben probar varios ASIN y marketplaces, documentar el límite de cobertura y evitar presentar una muestra parcial como un historial completo.
¿Qué diferencia hay entre una API de scraping y una API de datos?
Una API de scraping se organiza en torno a obtener y analizar páginas web. Sus entradas suelen ser URL, ASIN o términos, y sus salidas reflejan lo que expone la página. Una API de datos estructurados se organiza en torno a datos comerciales y esquemas documentados. Puede ofrecer endpoints específicos de historial de productos, inteligencia de palabras clave, análisis competitivo, reseñas, estimaciones de ventas o investigación de mercado. El enfoque estructurado reduce el trabajo de analizadores del cliente y puede combinar señales que no aparecen juntas en una sola página de Amazon.
¿Es legal hacer scraping de Amazon?
La respuesta depende de los datos, método de acceso, uso previsto, condiciones contractuales, obligaciones de privacidad y jurisdicción aplicable. La disponibilidad pública no concede automáticamente derechos ilimitados para recopilar, almacenar, republicar o comercializar datos. El acceso autenticado, datos personales, material protegido por derechos de autor e intentos de eludir controles técnicos pueden crear riesgos adicionales. Los equipos deben revisar las condiciones aplicables de Amazon, políticas de abastecimiento de datos del proveedor y requisitos jurídicos de su uso. Este artículo ofrece información técnica y de selección de productos, no asesoramiento jurídico.
¿Qué opción encaja con la investigación de mercados de Amazon?
Una API de scraping encaja si el equipo necesita campos personalizados de páginas concretas y está preparado para mantener validación, almacenamiento, historial y análisis. Una Amazon Data API estructurada encaja con flujos recurrentes que necesitan métricas conectadas de productos, palabras clave, competidores, reseñas, precios, ventas y mercados. Nexscope expone esos flujos mediante API documentadas y también admite acceso REST, MCP y web. La mejor opción depende de campos necesarios, cobertura de marketplaces, actualización, límites de datos estimados y frecuencia de actualización.
Fuentes
- Proxyway. (2025). Informe de API de scraping web 2025. Consultado en proxyway.com
- AIMultiple. (2026). Scrapers de Amazon clasificados por rendimiento. Consultado en aimultiple.com
- Bright Data. (2026). Documentación de Amazon Scraper API y descripción del producto. Consultado en brightdata.com
- Oxylabs. (2026). Objetivos de Amazon para Web Scraper API. Consultado en oxylabs.io
- Amazon. (2026). Condiciones de uso y políticas de programas. Consultado en amazon.com