¿Qué es Jev AI? 10 casos de uso, de los juegos al análisis publicitario
Jev AI tiene una tarea concreta: ayudar al software a decidir qué hacer a continuación. Un personaje de juego necesita una acción, un navegador necesita un siguiente paso y un flujo publicitario necesita etiquetas coherentes. Cada tarea puede implicar juicios repetidos, sin apenas necesidad de una explicación escrita entre ellos. Esas pequeñas decisiones son el foco del primer modelo System One de TypeSafe AI.
La idea se entiende mejor mediante ejemplos. Los primeros experimentos de la comunidad describen controladores de juegos, vehículos simulados, comentarios de escritura en tiempo real y análisis publicitario. Exploran qué ocurre cuando los desarrolladores pueden incorporar un modelo a un proceso repetido de decisión. Este artículo explica la interfaz básica de Jev y recorre diez usos comunicados, distinguiendo claramente entre un prototipo interesante y un sistema de producción probado. Para los equipos de marketing, los ejemplos de publicidad y filtrado de información son especialmente pertinentes: ambos organizan material para que una persona u otra parte del flujo pueda utilizarlo con más eficiencia.
¿Qué es Jev AI?
Jev es un modelo de TypeSafe AI construido para devolver decisiones estructuradas sobre las que el software puede actuar. Una aplicación proporciona contexto y define las preguntas que hay que responder. Los valores devueltos pueden determinar después qué acción se ejecuta o cómo se clasifica un elemento.
La interfaz documentada admite tres tipos de preguntas:
| Tipo | Finalidad | Pregunta de ejemplo |
|---|---|---|
| Choice | Seleccionar entre opciones definidas | ¿Qué categoría encaja mejor con este elemento? |
| Score | Evaluar con una rúbrica definida | ¿En qué medida coincide este texto con el criterio? |
| Noul | Estimar si una afirmación es verdadera | ¿Solicita este mensaje un reembolso? |
Son preguntas ilustrativas. Su utilidad depende del contexto y los criterios que proporcione el desarrollador.
TypeSafe presentó Jev el 15 de septiembre de 2026. Su anuncio de lanzamiento indica $0.042 por millón de tokens de entrada, sin cargo por tokens de salida. Ese es el precio del modelo; una aplicación completa también puede tener costes de datos, alojamiento, navegador u otros modelos.
10 casos de uso de Jev AI
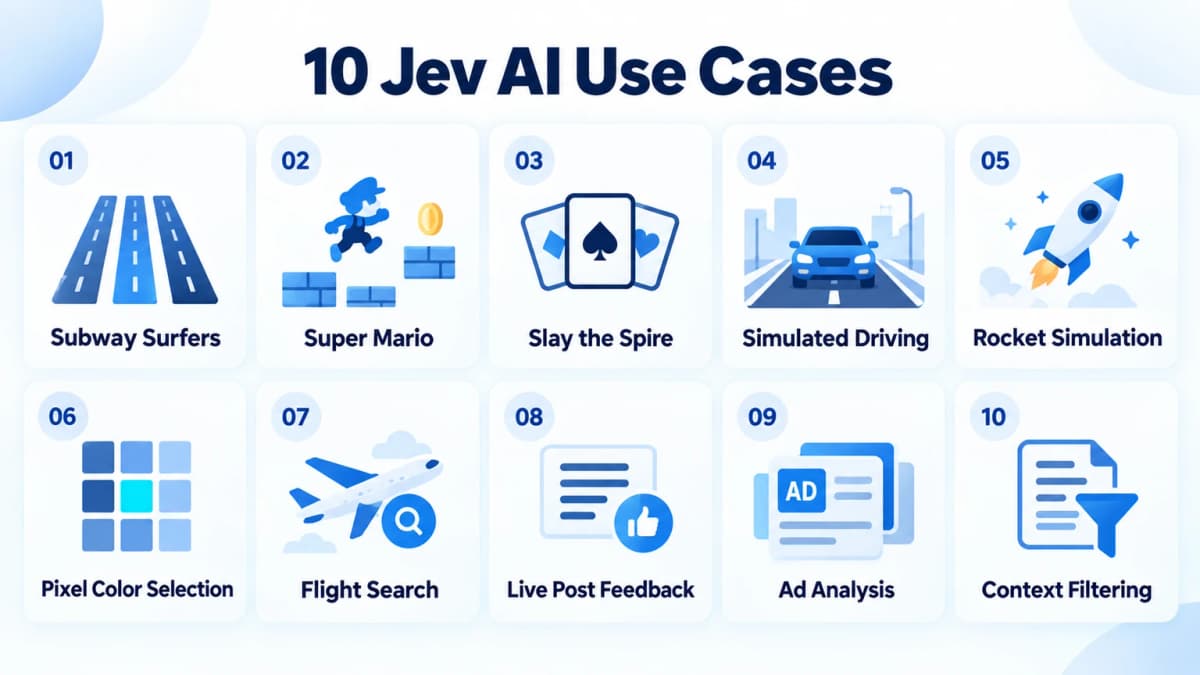
Los ejemplos siguientes describen prototipos comunicados por la comunidad y los patrones de decisión que ilustran. Su rendimiento no se ha reproducido aquí de forma independiente. Se omiten las afirmaciones concretas de tiempo y coste; el resultado de una demostración debe evaluarse en su propia configuración.
1. Partidas paralelas de Subway Surfers
Un experimento comunicado de Subway Surfers utiliza Jev para elegir acciones mientras se ejecutan varias partidas. La tarea implica decisiones repetidas, como cambiar de carril o responder a obstáculos.
Ejecutar varias sesiones hace más interesantes las preguntas operativas. ¿Puede cada sesión recibir una decisión antes de que cambie su estado? ¿Afecta una solicitud lenta solo a una partida? ¿Puede el controlador recuperarse después de un mal movimiento?
El patrón útil es la selección repetida de acciones entre sesiones independientes. Un prototipo funcional todavía tendría que mostrar cómo llega el estado del juego al modelo y cómo se convierte su salida en una entrada del juego. Un vídeo por sí solo no demuestra esos detalles ni la fiabilidad del controlador.
2. Controles de Super Mario Bros.
El ejemplo comunicado de Super Mario Bros. aplica la misma idea general al movimiento en plataformas. El progreso depende de elegir acciones en el momento adecuado cuando el personaje encuentra huecos, enemigos y obstáculos.
La diferencia entre elegir una acción y ejecutarla importa aquí. Incluso una elección sensata puede fallar si el juego ha avanzado antes de que llegue el comando. Por tanto, evaluar el sistema exige medir todo el ciclo, desde leer el estado hasta aplicar los controles.
Este caso hace visible la importancia del tiempo. Una prueba podría comparar tasas de finalización entre ejecuciones repetidas y registrar dónde surgen los errores: estado ausente, acciones inadecuadas o ejecución retrasada. Eso sería más informativo que la velocidad de una solicitud aislada al modelo.
3. Decisiones en Slay the Spire
Otro ejemplo de la comunidad describe a Jev seleccionando acciones en Slay the Spire 2. Un encuentro basado en cartas introduce un reto diferente: varias acciones legales pueden parecer razonables, pero su valor depende de la situación actual y de los turnos posteriores.
Una evaluación podría comprobar si la acción elegida es legal, si mejora la posición inmediata y si la partida acaba teniendo éxito. Son resultados separados. Una selección rápida no demuestra una estrategia sólida.
La aplicación más amplia es elegir entre un conjunto acotado de opciones con ventajas e inconvenientes contextuales. Los desarrolladores tendrían que decidir qué información pertenece al estado y si basta una decisión individual o hace falta un proceso de planificación separado.
4. Conducción urbana simulada
Una demostración comunicada de conducción sitúa a Jev en una simulación urbana tridimensional. El software presenta una situación cambiante, recibe una decisión y aplica una acción antes de repetir el proceso.
Esa configuración ilustra la retroalimentación: el resultado de una acción cambia la entrada de la siguiente. Entre las pruebas útiles estarían trazados de carretera desconocidos, estados incompletos y situaciones con varias acciones plausibles.
Una demostración de conducción simulada no aporta evidencia de preparación para carreteras reales. Su valor aquí es mostrar un ciclo de control experimental. Cualquier descripción debe identificar la simulación y evitar trasladar sus resultados a vehículos físicos.
5. Simulación de lanzamiento y aterrizaje de cohetes
El ejemplo del cohete describe a Jev participando en decisiones de lanzamiento y aterrizaje dentro de una simulación MuJoCo. Extiende la idea del ciclo de control a una tarea con fases cambiantes y una condición clara de éxito.
Un aterrizaje satisfactorio plantea preguntas útiles de seguimiento. ¿Con qué frecuencia tiene éxito con condiciones iniciales distintas? ¿Qué acciones están disponibles en cada fase? ¿Qué ocurre cuando el modelo selecciona una mala acción o falla una solicitud?
Es un prototipo de investigación que debe examinarse mediante pruebas repetidas. La evidencia más útil incluiría intentos fallidos y las condiciones de cada ejecución, junto con cualquier secuencia satisfactoria. Un solo aterrizaje no demuestra un rendimiento de control constante.
6. Selección de colores de píxeles
El experimento de arte con píxeles describe cómo convertir el dibujo en un conjunto de elecciones de color. Un programa pregunta por un color en una ubicación y representa después los valores seleccionados como una imagen.
Es una forma útil de hacer visible una salida restringida. La aplicación define la paleta disponible y controla la representación. La calidad del resultado depende de cómo se relacionen las elecciones individuales con la imagen general.
Este experimento no demuestra una capacidad general de generación de imágenes. Muestra una posible forma de componer muchas selecciones pequeñas. Una evaluación justa preguntaría si la imagen sigue la descripción prevista y mantiene la coherencia cuando aumenta su tamaño o detalle.
7. Búsquedas de vuelos en el navegador
El flujo comunicado de búsqueda de vuelos combina acciones del navegador con un componente separado de generación de texto. Jev elige qué hacer a continuación, mientras otro modelo gestiona la introducción de texto cuando es necesario.
La búsqueda de vuelos concreta el reparto del trabajo. Seleccionar un campo, introducir un destino, elegir fechas y leer las opciones resultantes son operaciones diferentes. La aplicación debe mantener coherentes su orden y estado.
El resultado significativo es un conjunto correcto de opciones para el itinerario solicitado. La evaluación debe incluir fechas, datos de pasajeros y si la búsqueda realmente se completó. Una secuencia rápida de clics solo es útil si termina en el resultado correcto. Completar una búsqueda también sigue siendo distinto de reservar o pagar.
8. Comentarios en directo sobre publicaciones sociales
El prototipo comunicado de Riley Brown evalúa una publicación social mientras se escribe y devuelve comentarios actualizados a medida que cambia el texto. La interacción sitúa la evaluación cerca de la edición que la provocó.
Una versión útil de este flujo podría mostrar criterios separados, como claridad o el grado en que el inicio identifica expresamente el tema. Esas puntuaciones facilitarían ver por qué una revisión cambió los comentarios. Son dimensiones propuestas de evaluación, no funciones verificadas de la demostración.
Las afirmaciones sobre potencial viral requieren especial cuidado. La valoración de un modelo es una estimación según sus instrucciones. El alcance real también depende del público y las condiciones de distribución. La puntuación puede ayudar a comparar borradores, pero su relación con el rendimiento necesita evidencia de publicaciones realizadas.
9. Clasificación y análisis publicitario
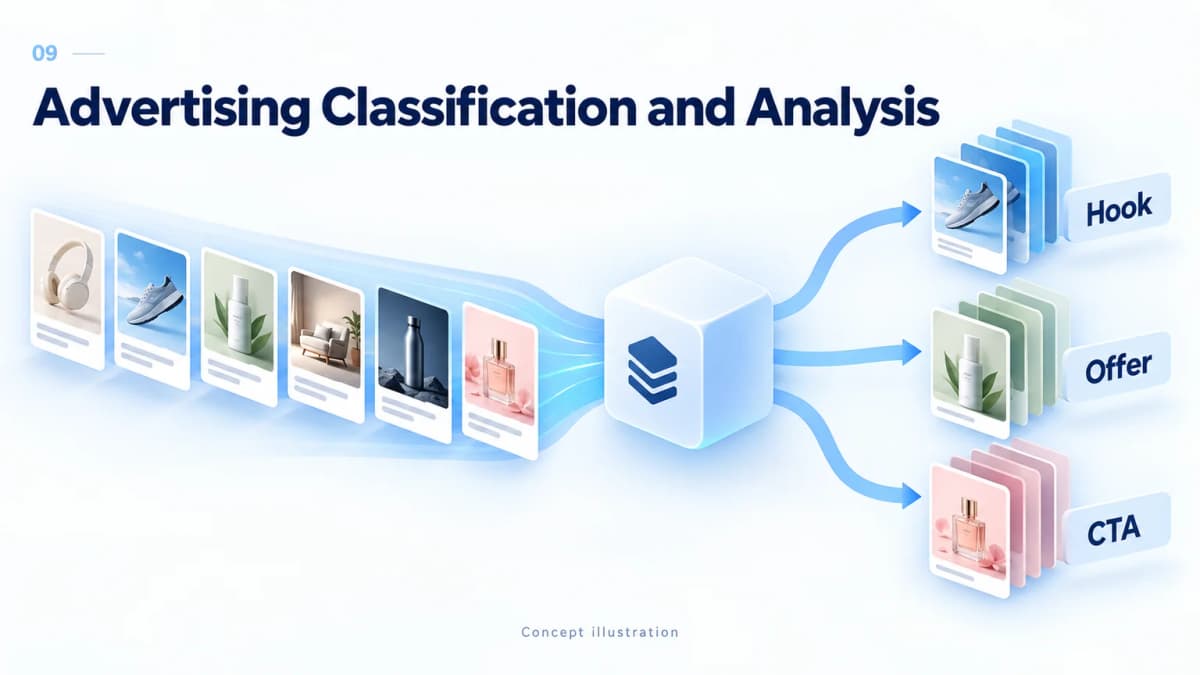
La demostración publicitaria comunicada de Matthew Berman utiliza Jev para organizar anuncios según rasgos como el gancho inicial, el formato, la oferta y la llamada a la acción. Es una de las aplicaciones empresariales más claras del conjunto.
Unas etiquetas coherentes permitirían a un analista filtrar una colección en lugar de releer cada elemento. Por ejemplo, podrían revisarse juntas las ofertas centradas en descuentos o compararse las demostraciones de productos con otros formatos. El analista podría examinar después los anuncios que importan para una pregunta concreta.
Para construir un flujo similar de investigación, empieza con un conjunto definido de anuncios. Las API de datos de marketing de Nexscope incluyen muestras de anuncios de búsqueda de pago que un equipo puede incorporar a su propio flujo mediante una API REST o MCP. El texto devuelto puede servir como entrada para que un modelo clasifique mensajes y señale elementos para revisión, según la cobertura de la muestra y los campos disponibles.
Un profesional de marketing podría agrupar después ofertas similares, comparar llamadas a la acción y utilizar los hallazgos para preparar un brief de campaña. Revisar manualmente una muestra de etiquetas ayuda a afinar los criterios antes de procesar más registros.
Las etiquetas de anuncios describen el contenido creativo; no demuestran qué anuncios convierten. Los juicios de rendimiento requieren datos adecuados de campaña. Del mismo modo, evaluar la coherencia de un anuncio con su página de destino exige disponer de ambos contenidos para compararlos.
10. Filtrado del contexto de agentes
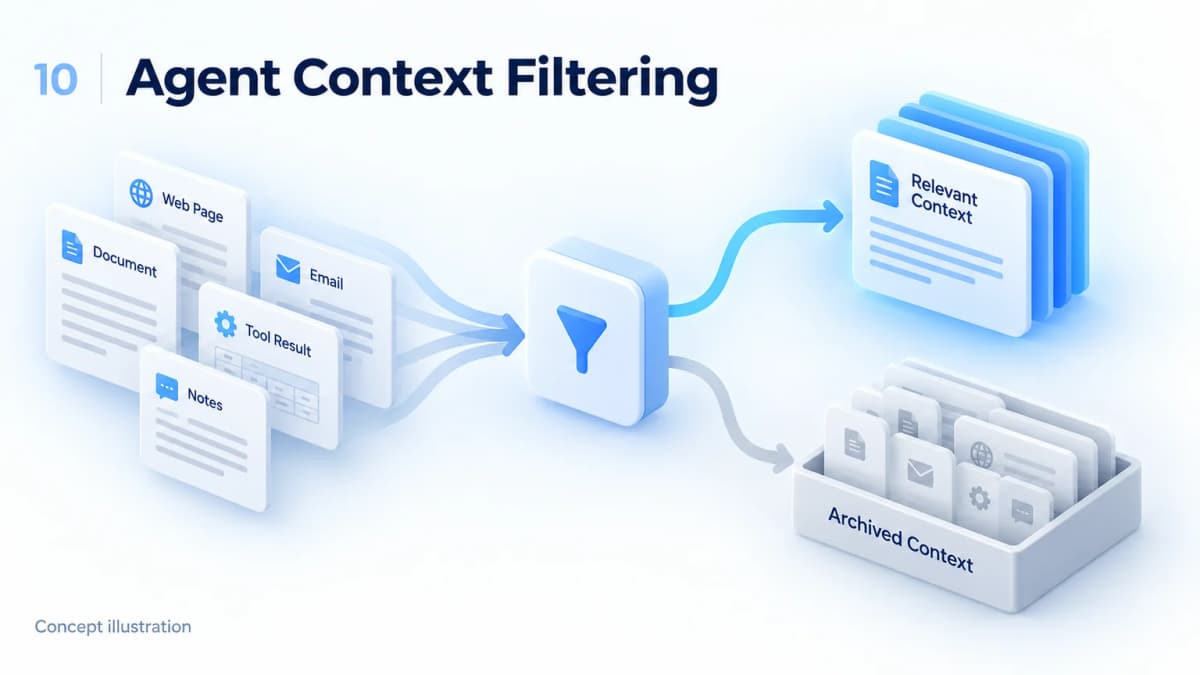
El último ejemplo comunicado utiliza Jev para evaluar la pertinencia de registros de llamadas a herramientas acumulados por un agente de IA. Esos registros pueden incluir páginas recuperadas, fragmentos de archivos y resultados anteriores de herramientas.
Seleccionar material para el siguiente paso introduce otro equilibrio de calidad. Eliminar registros irrelevantes puede reducir lo que debe procesar el agente, pero descartar una instrucción o un resultado necesarios puede perjudicar la tarea.
Una implementación propuesta debe mantener recuperables los registros originales y probar si el agente puede seguir completando las mismas tareas después del filtrado. La pertinencia también cambia a medida que avanza la tarea. Un registro que parece innecesario en un paso puede importar más adelante, por lo que las reglas de conservación necesitan más cuidado que una puntuación puntual.
Conclusión
Los diez ejemplos comparten una estructura recurrente: el software proporciona una situación, Jev evalúa una pregunta acotada y la aplicación utiliza el resultado. Los juegos hacen que ese ciclo sea fácil de ver. El análisis publicitario y el filtrado de contexto muestran cómo el mismo enfoque general podría ayudar a organizar información.
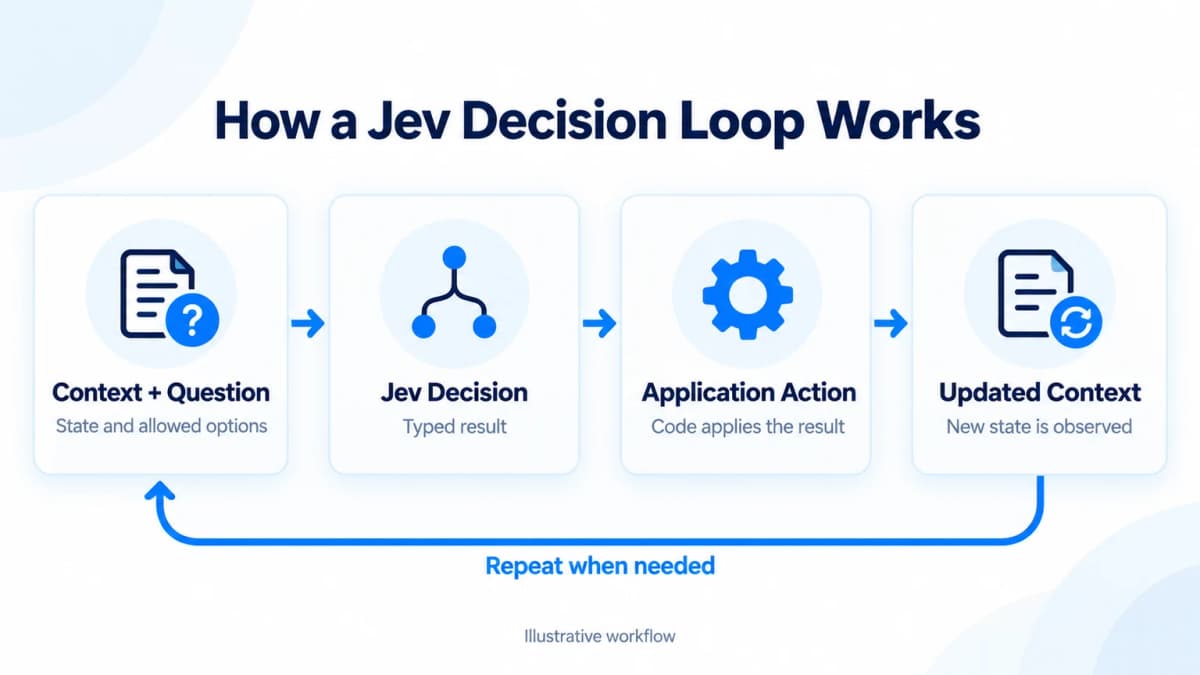
Ciclo de decisión ilustrativo; los detalles de implementación varían según la aplicación.
Los patrones de aplicación documentados de TypeSafe incluyen enrutamiento de intenciones, puntuación compuesta y enrutamiento basado en confianza. Proporcionan puntos de partida para experimentar. Un primer proyecto útil debe tener una decisión clara, errores medibles y una forma de revisar resultados inciertos.
Desarrolla con datos de marketing
El mismo enfoque puede apoyar una investigación de marketing más amplia: agrupar intenciones de búsqueda, comparar mensajes competidores, priorizar oportunidades de contenido o revisar cambios en la visibilidad de una marca. Cada flujo empieza con una pregunta empresarial y evidencia pertinente.
Los datos de marketing de Nexscope abarcan palabras clave, resultados de búsqueda, inteligencia de competidores y sitios web, enlaces entrantes, publicidad y visibilidad en IA. Los equipos pueden conectar los conjuntos compatibles con sus propios agentes y flujos mediante una API REST o MCP y utilizar después un modelo de decisión para organizar hallazgos y dirigir la siguiente acción. La cobertura y las estimaciones de los conjuntos de datos deben seguir siendo visibles a medida que la información recorre el flujo.
Construye tu flujo de investigación de marketing
Conecta datos de marketing con tus propios agentes y convierte los hallazgos de investigación en siguientes pasos fundamentados.
Explorar las API de datos de marketing →Preguntas frecuentes
¿Para qué se utiliza Jev AI?
Jev está diseñado para juicios estructurados dentro del software, como elegir entre opciones y puntuar una entrada con criterios definidos. TypeSafe describe patrones de aplicación como el enrutamiento y la puntuación compuesta. Los ejemplos del artículo exploran esas ideas en juegos, operaciones del navegador, comentarios de contenido y filtrado de información. Su utilidad depende de la implementación y de la calidad de su evaluación.
¿Puede Jev sustituir a un chatbot de propósito general?
La interfaz documentada de Jev devuelve decisiones tipadas en lugar de respuestas escritas libres. Una aplicación que necesite explicaciones, redacción o texto generado necesitaría un componente adecuado para esas tareas. El ejemplo comunicado de navegador ilustra cómo distintos componentes pueden contribuir a un flujo. Elegir cómo repartir el trabajo exige probar la tarea completa, incluidos sus casos de fallo.
¿Cuánto cuesta Jev?
El anuncio de lanzamiento de TypeSafe del 15 de septiembre de 2026 indica un precio de entrada de $0.042 por millón de tokens y ningún cargo por tokens de salida. Esa cifra cubre el uso del modelo con los precios indicados. El coste total de un flujo también puede incluir obtener datos, ejecutar infraestructura, operar un navegador o llamar a otros modelos. Deben comprobarse las condiciones actuales antes de estimar un presupuesto de despliegue.
¿Toma Jev siempre decisiones correctas?
Una salida estructurada no demuestra que un juicio sea correcto. La documentación de confianza de TypeSafe explica cómo las respuestas Choice y Score expresan incertidumbre mediante distribuciones de probabilidad y un valor derivado de confianza. Una aplicación puede utilizar esa información para pedir revisión o seguir otra vía. Los umbrales adecuados dependen de las consecuencias de los errores y del rendimiento observado en la tarea real.
¿Puede Jev ayudar con el análisis de marketing?
La clasificación y la puntuación ofrecen puntos de partida plausibles para el análisis de marketing. Un equipo podría probar la categorización de mensajes publicitarios, la agrupación de intenciones de búsqueda o la priorización de hallazgos. Cada tarea necesita criterios claros, datos de entrada adecuados y comprobaciones manuales. Las etiquetas y puntuaciones generadas por el modelo deben evaluarse por separado de resultados empresariales como conversiones, ingresos o rendimiento de campañas, que requieren sus propios datos de apoyo.
Fuentes
- TypeSafe AI. (2026). Presentación de los modelos System One y Jev. Recuperado de typesafe.ai
- TypeSafe AI. (2026). Introducción. Recuperado de docs.typesafe.ai
- TypeSafe AI. (2026). Confianza. Recuperado de docs.typesafe.ai
- TypeSafe AI. (2026). Patrones. Recuperado de docs.typesafe.ai