GPT-6 frente a GPT-5.6 para vendedores de Amazon: ¿deberías actualizar?
Comparar GPT-6 y GPT-5.6 plantea tres preguntas a los vendedores de Amazon: qué capacidades han mejorado, dónde importan esas mejoras en las operaciones diarias y si merece la pena probar una actualización. Un modelo puede producir una explicación convincente de una caída de ventas y aun así dejar a alguien la conciliación de informes, la comprobación de cálculos y la decisión de qué hacer después.
El argumento práctico a favor de GPT-6 Astra empieza con tareas que requieren varias acciones conectadas. Para un vendedor, eso podría significar investigar el rendimiento publicitario, resolver un error de ficha o contrastar el inventario con necesidades de reposición. La comparación útil es con qué fiabilidad entrega cada modelo un resultado que el equipo pueda verificar. Las secciones siguientes cubren las pruebas pertinentes, tres escenarios operativos, costes API y una prueba comparativa breve. Todos los ejemplos empresariales son hipotéticos. Ilustran qué evaluar, no resultados de una tienda real de Amazon.
1. Diferencias de capacidad
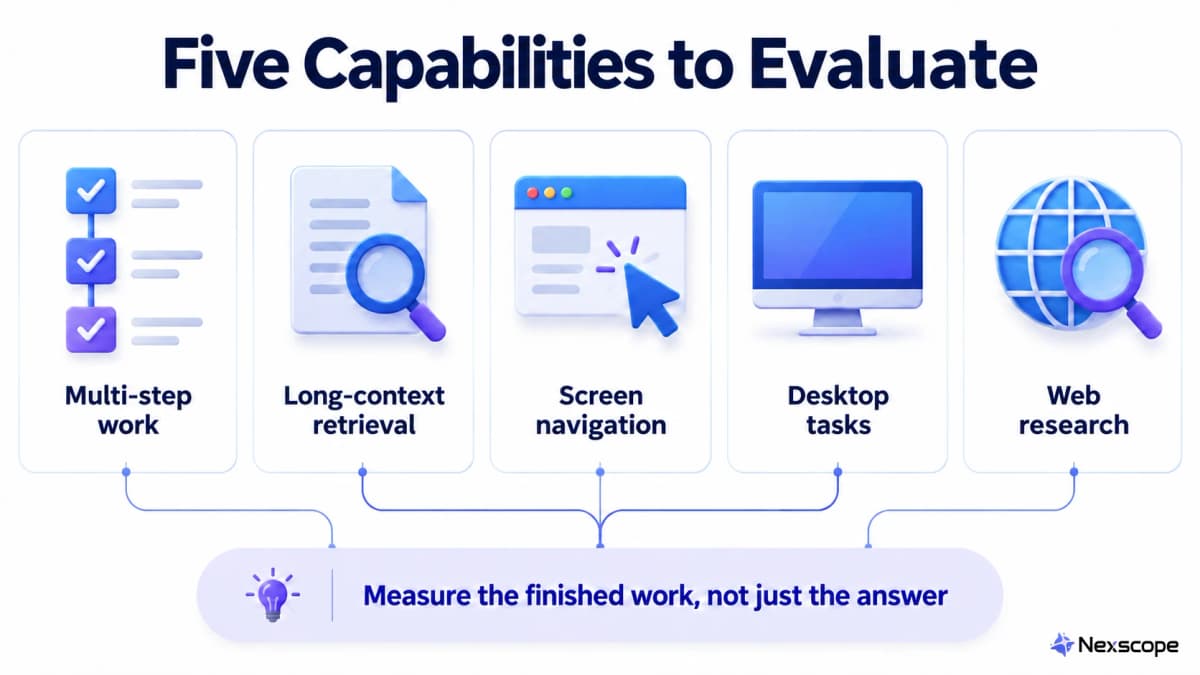
Los nombres de las pruebas resultan más útiles al traducirlos al trabajo que evalúan:
| Prueba de referencia | Capacidad evaluada |
|---|---|
| AutomationBench | Completar tareas prolongadas de automatización |
| MRCR v2 | Recuperar información de conversaciones largas |
| ScreenSpot-Pro | Localizar elementos de interfaz en capturas |
| OSWorld 2.0 | Realizar tareas en aplicaciones de escritorio |
| BrowseComp | Encontrar información difícil mediante investigación web |
Para un vendedor que evalúa un asistente, estas pruebas sugieren criterios de aceptación distintos. ¿Usa un diagnóstico publicitario todos los archivos pertinentes? ¿Identifica una investigación de ficha el campo correcto? ¿Puede otra persona reproducir el cálculo de inventario?
Antes de comparar modelos, identifica dónde falla el flujo actual. Los archivos ausentes, una instrucción ambigua y un error aritmético requieren soluciones diferentes. Cambiar el modelo no le da automáticamente acceso a las cuentas del vendedor ni resuelve la falta de datos.
2. Mejoras y límites de las pruebas
OpenAI comunica los siguientes resultados en su tabla de evaluación de GPT-6 Astra:
| Prueba de referencia | GPT-5.6 Sol | GPT-6 Astra | Mejora en puntos porcentuales |
|---|---|---|---|
| AutomationBench | 18.1% | 41.4% | +23.3 |
| MRCR v2, 8 elementos objetivo, 512K–1M | 73.8% | 96.3% | +22.5 |
| ScreenSpot-Pro, sin herramientas | 76.9% | 92.7% | +15.8 |
| OSWorld 2.0, sin conexión, puntuación parcial | 65.7% | 72.6% | +6.9 |
| BrowseComp | 90.4% | 91.5% | +1.1 |
AutomationBench más que se duplica, mientras que la recuperación y la localización en pantalla muestran mejoras sustanciales. Las diferencias en OSWorld y BrowseComp son menores. Son puntuaciones máximas entre los esfuerzos de razonamiento probados; el comportamiento en producción puede diferir. La fila OSWorld usa la versión 2026.08.08 y puntuación parcial.
Una puntuación en una prueba no es una tasa de éxito a nivel de tienda. Los vendedores deberían tratar esas diferencias como motivos para elegir tareas de prueba sin convertirlas en promesas de mejora de ingresos, precisión de conciliación o recuperación de fichas.
Ambos modelos tienen una ventana de contexto de 1,050,000 tokens, según las especificaciones de los modelos Astra y Sol. Por tanto, la mejora comunicada de recuperación no procede de una ventana anunciada mayor. Encontrar una cifra pertinente y usarla correctamente en un cálculo empresarial siguen siendo comprobaciones separadas.
3. Tres escenarios para vendedores de Amazon
Los siguientes escenarios convierten la comparación en trabajo que un vendedor puede inspeccionar. Cada uno necesita herramientas conectadas o informes proporcionados, instrucciones explícitas y una definición de finalización.
Diagnóstico publicitario
Un informe publicitario puede mostrar un ACoS creciente sin explicar la causa. Las preguntas siguientes suelen implicar otros registros: ¿cayó la conversión?, ¿cambió el precio? o ¿se quedó un producto corto de stock disponible?
Una comparación útil pide a ambos modelos que unan los mismos datos de publicidad, ventas, inventario y costes de 28 días. El entregable debe identificar productos o términos de búsqueda afectados, mostrar el cálculo y separar cambios observados de posibles explicaciones. Registra con qué frecuencia alguien debe corregir un intervalo de fechas o aportar una unión ausente entre archivos.
Considera un producto hipotético con $25 de ingresos netos por ventas por pedido. Después de la adquisición, costes puestos en destino, tarifas por referencia, gestión logística y otros costes no publicitarios incluidos, quedan $8:
- ACoS de equilibrio: $8 ÷ $25 = 32%.
- Con un ACoS del 38%, la publicidad cuesta $25 × 38% = $9.50 por pedido.
- La contribución después de publicidad es $8 − $9.50 = −$1.50 por pedido.
Este ejemplo simplificado supone definiciones coherentes de ingresos y atribución. Cualquier coste omitido cambia el umbral.
La evaluación debería comprobar si el asistente conecta esa pérdida con una próxima acción respaldada. Un resultado no rentable por sí solo no demuestra que lo causaran una puja, palabra clave, página de producto o problema de stock.
Resolución de errores de fichas
Una investigación de ficha necesita más que una explicación sencilla de un error. Debe conectar el error con el campo afectado, la información verificada del producto y la próxima corrección que revisar.
Da a ambos modelos el mismo mensaje de error, los atributos actuales de la ficha y los documentos de apoyo del producto. Pide una tabla compacta con el valor actual, la corrección propuesta, las pruebas y cualquier elemento que aún falte. Si no hay una especificación de material o certificado, la salida debe identificar esa carencia.
Cuando haya acceso autorizado al navegador, navegar por la interfaz puede formar parte de la prueba. Puntúa la investigación por separado de los cambios propuestos. Un modelo que encuentra el campo correcto pero inventa un valor de sustitución ha fallado la tarea.
Una solicitud aceptada no demuestra que una ficha vuelva a estar disponible para vender. Completar requiere comprobar el estado resultante y registrar los problemas pendientes. Los vendedores pueden probar primero el diagnóstico antes de permitir cambios.
Conciliación de inventario y beneficio
Las decisiones de inventario se complican cuando aparecen varias definiciones de «stock» en distintos sistemas. El stock del almacén puede incluir unidades reservadas, una orden de compra puede seguir en tránsito y una estimación de llegada puede excluir el tiempo de recepción.
Pide a ambos modelos que concilien los mismos registros SKU e indiquen qué cantidades pueden respaldar realmente las ventas. La moneda, los alias de SKU, las fechas de entrega ausentes y los costes no disponibles deben ser visibles en la salida.
Para un artículo hipotético:
| Entrada o cálculo | Resultado |
|---|---|
| Inventario vendible | 600 unidades |
| Demanda diaria media | 20 unidades |
| Cobertura actual: 600 ÷ 20 | 30 días |
| Tiempo hasta que la reposición sea vendible | 45 días |
| Margen adicional de planificación | 10 días |
| Cobertura objetivo: 45 + 10 | 55 días |
| Stock necesario: 55 × 20 | 1,100 unidades |
| Déficit de planificación: 1,100 − 600 | 500 unidades |
Esto supone demanda constante y ningún otro stock entrante utilizable. El déficit de 500 unidades describe la situación de planificación; un pedido que llegue después de la rotura de stock no puede evitar la escasez anterior.
Un asistente útil debería comparar las implicaciones de plazo y margen de acelerar el stock, ajustar la publicidad o aceptar una escasez temporal. El vendedor aún debe decidir qué opción encaja con el efectivo disponible y las restricciones de proveedores.
4. Precios y valor de la actualización
Tarifas API estándar
Según se comprobó el 9 de septiembre de 2026, los precios oficiales de Astra y los precios de Sol son:
| Uso API estándar | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| Entrada, por millón de tokens | $4 | $10 |
| Salida, por millón de tokens | $20 | $50 |
| 100,000 tokens de entrada + 10,000 tokens facturados de salida | $0.60 | $1.50 |
Las tarifas estándar de entrada y salida son ambas 2.5 veces mayores en Astra. Los precios promocionales de Sol están disponibles al menos hasta el 21 de noviembre de 2026. Son tarifas API, no precios de suscripciones ChatGPT.
El ejemplo supone entrada sin caché y procesamiento Standard. Los modos de procesamiento, el almacenamiento en caché, los precios de contexto largo y los cargos de herramientas pueden cambiar la factura. Los 10,000 tokens facturados de salida ya incluyen los tokens de razonamiento, que OpenAI factura a tarifas de salida. Contar solo el texto visible de respuesta subestimaría el uso. Consulta la explicación de facturación de tokens de razonamiento.
Coste por tarea completada
Con esos recuentos idénticos de tokens, Astra añade $0.90. Las tareas reales pueden usar cantidades distintas de entrada, razonamiento, salida y reintentos en cada modelo.
Una comparación práctica es:
Coste total de tarea = cargos de modelos y herramientas + coste de revisión humana + coste de rehacer trabajo.
Como ilustración, tres minutos de revisión ahorrados con un coste laboral supuesto de $30 por hora valen $1.50. Eso superaría la diferencia de $0.90 del ejemplo. Si el tiempo de revisión y la calidad no cambian, la tarifa mayor necesita otra justificación.
Usa resultados medidos para decidir qué trabajo trasladar:
| Tipo de tarea | Enfoque de evaluación sugerido |
|---|---|
| Diagnóstico entre informes, investigación de errores complejos y revisión final | Probar Astra en casos con comprobación o repetición sustanciales |
| Informes rutinarios con entradas estables | Comparar ambos modelos con la plantilla o script existentes |
| Traducción, extracción fija y preguntas sencillas | Conservar la opción actual salvo que las pruebas demuestren una mejora valiosa |
Son puntos de partida para evaluar. Una diferencia pequeña en una prueba no puede determinar el valor de todas las tareas de una categoría.
5. Una prueba comparativa de una semana
Elige una tarea recurrente con una salida clara, como identificar productos con rendimiento publicitario deteriorado y cobertura limitada de inventario.
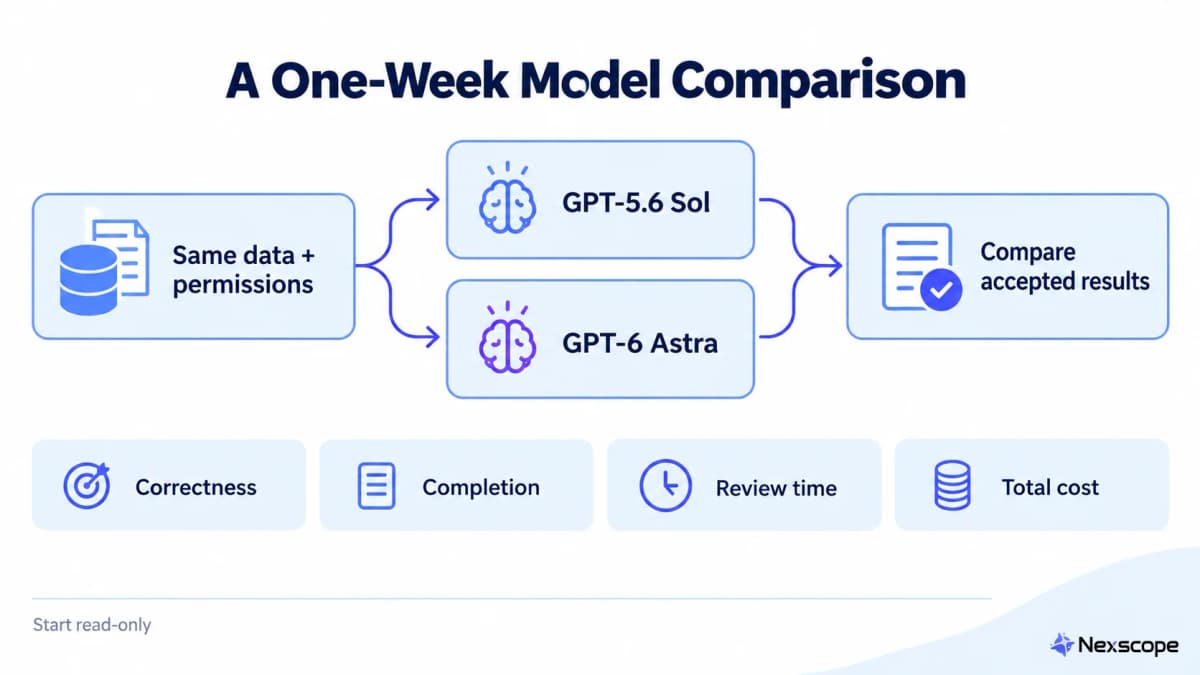
Da a ambos modelos los mismos datos congelados, permisos de herramientas y criterios de aceptación. Registra los ID de modelos y los ajustes de razonamiento. Empieza con trabajo de solo lectura y conserva los fallos y reintentos en la comparación.
Registra cuatro cosas:
| Métrica | Qué comprobar |
|---|---|
| Corrección | Cálculos reproducibles, definiciones coherentes y afirmaciones respaldadas |
| Finalización | Todas las salidas requeridas entregadas con pruebas trazables |
| Intervención humana | Aclaraciones, correcciones y minutos de revisión |
| Coste total | Uso de modelos y herramientas más tiempo de revisión y repetición de trabajo |
Unas instrucciones de prueba podrían ser:
Audita los informes proporcionados de publicidad, ventas, stock y costes de los últimos 28 días. Devuelve cinco problemas ordenados por impacto empresarial estimado. Para cada uno, identifica el producto afectado, muestra los registros y cálculos de apoyo, explica la acción propuesta y enumera los supuestos sin resolver. Comprueba mercado, moneda, periodos de informe y actualidad antes de comparar cifras. No cambies ajustes de la cuenta. Termina con los datos necesarios para verificar cada problema en la próxima ejecución.
Ejecuta la comparación con los casos disponibles de la semana. Un resultado prometedor respalda una prueba piloto limitada; no demuestra fiabilidad para todas las tareas futuras. Comprueba si la aparente mejora se mantiene con otro producto, datos ausentes o un error inesperado.
Si el flujo resulta útil, define con precisión cualquier acceso posterior de escritura: productos o campañas aprobados, cambios permitidos, límites de ajustes y un procedimiento de recuperación. La programación y supervisión también requieren un entorno operativo que registre si realmente se completó cada ejecución.
6. Conclusión
Los vendedores de Amazon deberían evaluar GPT-6 mediante el trabajo que quieren delegar. El diagnóstico publicitario, las investigaciones de fichas y la conciliación de inventario ofrecen pruebas concretas porque sus salidas pueden contrastarse con registros y cálculos.
Actualiza las tareas en las que una comparación muestre mejor finalización, menos correcciones o una reducción valiosa del esfuerzo total. Sigue revisando las pruebas a medida que amplías el flujo. Una prueba piloto satisfactoria debería liberar tiempo para decisiones de producto, conversaciones con proveedores y mejoras que aún dependen del criterio del vendedor.
Añade contexto del mercado de Amazon
Algunas investigaciones también necesitan pruebas externas. Un vendedor que examine una caída de conversión puede querer comparar precios de productos competidores o quejas de reseñas junto con informes internos de rendimiento.
Nexscope proporciona datos de comercio electrónico que los equipos pueden conectar a sus propios agentes y flujos mediante REST API o MCP. Su API de datos de Amazon puede aportar información pertinente de productos, precios y reseñas para esa comparación. Los informes publicitarios privados, registros de inventario y costes de compra aún deben proceder de los sistemas autorizados del vendedor.
Usa esas entradas juntas para producir un diagnóstico con fuentes identificables, carencias explícitas y un resultado que el equipo pueda comprobar.
Incorpora datos de Amazon a tu flujo
Conecta datos de productos, precios y reseñas a tu propio agente mediante REST API o MCP.
 Explorar la API de datos de Amazon →
Preguntas frecuentes
¿Deberían los vendedores de Amazon actualizar a GPT-6?
Empieza con una comparación controlada de una tarea que actualmente requiera mucha comprobación o repetición. El diagnóstico publicitario, las investigaciones de fichas y la conciliación de inventario ofrecen salidas inspeccionables. Traslada el flujo cuando la calidad medida, la finalización y el esfuerzo humano justifiquen el cambio. Mantén los procesos rutinarios que funcionan mientras recopilas pruebas de dónde ayuda otro modelo.
¿Cuesta GPT-6 2.5 veces más por tarea?
Sus tarifas API Standard publicadas de entrada y salida son 2.5 veces las tarifas actuales de Sol. Una tarea individual puede consumir distintos recuentos de tokens en los dos modelos, por lo que su coste real no tiene por qué seguir esa proporción. Incluye razonamiento, reintentos, herramientas y revisión humana en la comparación. El ejemplo anterior mantiene constante el uso de tokens solo para ilustrar la diferencia de precio.
¿Puede GPT-6 acceder automáticamente a Seller Central?
Seleccionar un modelo no proporciona acceso a una cuenta de vendedor de Amazon. Un asistente necesita una conexión de herramientas autorizada adecuadamente, una sesión de navegador o informes cargados. Define qué puede leer y qué acciones puede realizar. Una primera prueba útil pide un diagnóstico y correcciones propuestas sin permitir cambios en fichas, inventario o ajustes publicitarios.
¿Garantiza una mejor recuperación cálculos precisos de inventario?
La recuperación y la aritmética necesitan comprobaciones separadas. Encontrar una cifra de stock no demuestra si incluye unidades reservadas, si coincide el SKU o si un envío entrante llegará a tiempo. Un flujo de inventario debería exponer esas definiciones y supuestos y mostrar después cálculos que otra persona pueda reproducir. Las fechas o cantidades de entrega ausentes deben seguir sin resolver hasta estar respaldadas.
¿Qué debería medir una prueba de modelos de una semana?
Mide corrección, finalización, intervención humana y coste total con las mismas instantáneas de entrada y criterios de aceptación. Registra fallos y reintentos además de ejecuciones satisfactorias. Compara el tiempo necesario para alcanzar un entregable aceptable, incluidas las correcciones manuales. Trata una semana de resultados como pruebas para una prueba piloto limitada y sigue comprobando el rendimiento a medida que aumente la variedad de tareas.
Fuentes
- OpenAI. (2026). GPT-6 Astra: una nueva generación de inteligencia. Recuperado de openai.com.
- OpenAI. (2026). Modelo GPT-6 Astra. Recuperado de developers.openai.com.
- OpenAI. (2026). Modelo GPT-5.6 Sol. Recuperado de developers.openai.com.
- OpenAI. (2026). Modelos de razonamiento. Recuperado de developers.openai.com.